robots.txt y rastreadores de IA: qué decidir sobre el acceso a tu contenido
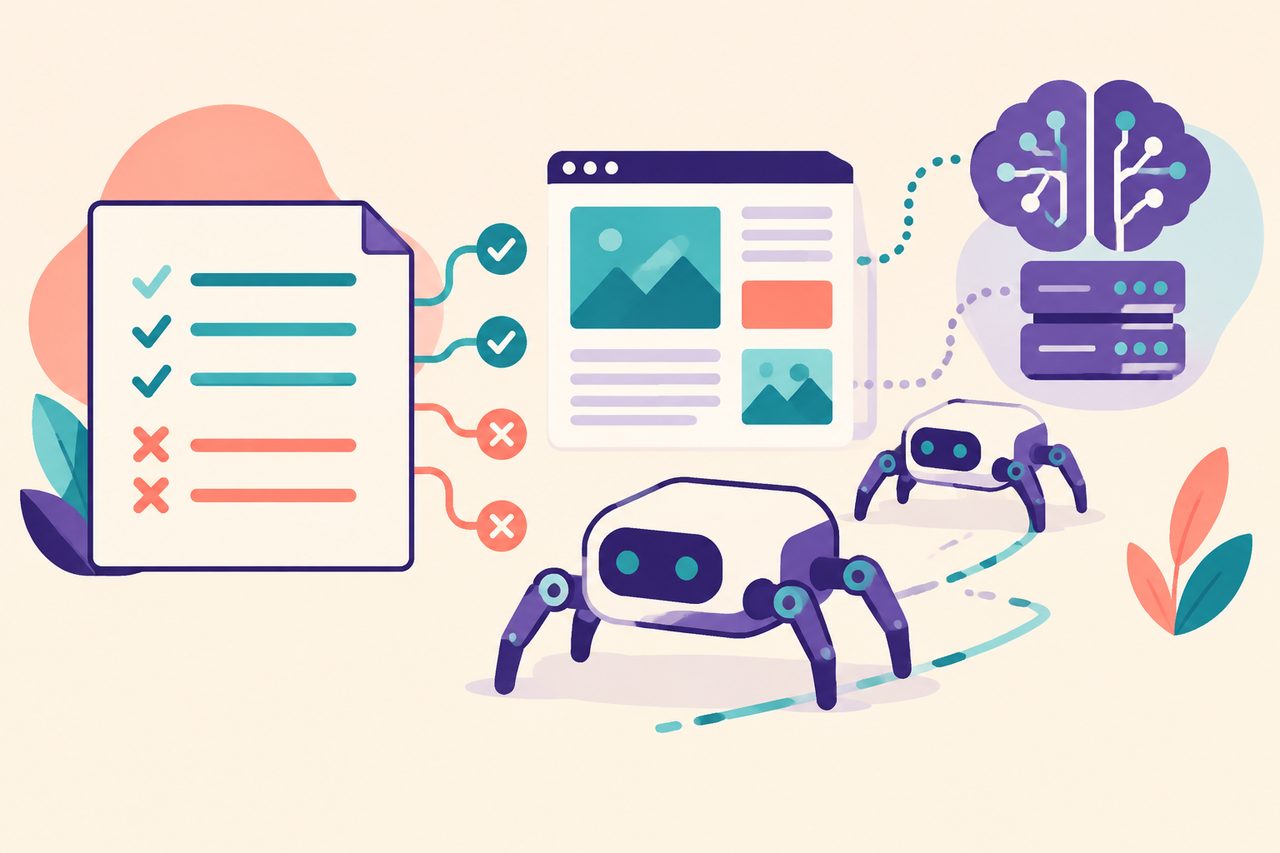
Robots.txt indica qué rastreadores pueden acceder a qué partes del sitio.
Hay dos posturas
- Permitir: más posibilidades de ser leído y citado.
- Bloquear: más control sobre el uso del contenido, con menos presencia.
Consejos
- Consulta la documentación oficial de cada rastreador para conocer su nombre exacto.
- Revisa que no bloqueas sin querer el acceso de buscadores tradicionales.
- Deja constancia de la decisión y revísala periódicamente.
Importante
Robots.txt es una petición de cortesía que los rastreadores respetan de forma voluntaria.
Los rastreadores de OpenAI, según su documentación
OpenAI describe varios agentes con funciones distintas e independientes: OAI-SearchBot (para mostrar sitios en las búsquedas de ChatGPT), GPTBot (rastreo de contenido que puede usarse para entrenar modelos; bloquearlo indica que no quieres ese uso) y ChatGPT-User (acciones iniciadas por un usuario, para las que las reglas de robots.txt pueden no aplicarse igual). Permitir uno y bloquear otro es una decisión posible.
En Google, el control para limitar el rastreo en Search es robots.txt para Googlebot; para limitar fragmentos se usan directivas como nosnippet o noindex. Para limitar entrenamiento y uso en otros sistemas existe el control Google-Extended.
Cómo decidir
Pregúntate: ¿prefiero ser localizable en asistentes de búsqueda aunque mi contenido pueda usarse para entrenar? Registra la decisión y revisa los nombres de los agentes en la documentación oficial, porque cambian.
Precaución
Bloquear por error el rastreo de buscadores tradicionales puede hacerte desaparecer de ellos. Prueba siempre tras cambiar el archivo.
Lecturas oficiales relacionadas
- Google Search Central: introducción a robots.txt
- OpenAI: visión general de sus rastreadores
- Google Search Central: funciones de IA y tu sitio web
Newsletter de Brandiario
Un resumen de lo que publicamos. Sin enviarte nada hasta que te apuntes.